GLM‑5.3‑Flash: Multimodales Open‑Weights‑Modell auf Schweizer Infrastruktur
29.09.2026 | Neuigkeiten | Luca Albrecht
Das Modell auf einen Blick:
- Mixture‑of‑Experts‑Architektur: 320 Mrd. Parameter, 18 Mrd. aktiv pro Token
- Kontextfenster: bis zu 262'144 Tokens
- Hybrid‑Attention (Sparse + linear) reduziert Kosten bei langen Eingaben
- OpenAI‑kompatible API, vollständig in der Schweiz gehostet
- Anwendungsbereiche: Software‑Entwicklung, Debugging, grosse Dokumenten‑ und Bildanalysen, agentenbasierte Workflows
GLM‑5.3‑Flash ist die aktuellste Erweiterung zu unserem AI on Demand Sortiment. Das Modell nutzt eine Mixture‑of‑Experts‑Architektur mit 320 Mrd. Parametern, wobei pro Token lediglich rund 18 Mrd. aktiv werden. Durch die Kombination von Sparse‑ und linearer Attention werden die Rechenkosten bei sehr langen Kontexten reduziert, sodass das Modell ein Kontextfenster von bis zu 262'144 Tokens verarbeiten kann.
Der grosse Kontext ermöglicht die Analyse umfangreicher Dokumentensammlungen, langer Gesprächsverläufe oder komplexer technischer Spezifikationen. Gleichzeitig können Kunden das „Thinking‑Budget“ steuern und die Reasoning‑Tiefe an die jeweilige Aufgabe anpassen, von schneller Vor‑Analyse bis zu tiefgehenden, mehrstufigen Überlegungen.
Die komplette Ausführung erfolgt auf unserer Schweizer Infrastruktur, wodurch Daten in der Schweiz bleiben und unserem hohen Datenschutz‑ und Sicherheitsstandard gerecht werden. Der Zugriff erfolgt über eine standardisierte OpenAI‑kompatible API, die sich nahtlos in bestehende Anwendungen, Entwicklungsumgebungen und agentenbasierte Systeme einbinden lässt.
Typische Einsatzbereiche umfassen die Softwareentwicklung (Code‑Analyse, Debugging, automatisierte Refactorings), die Verarbeitung grosser Informationsbestände, Bild‑ und Dokumentenanalyse sowie agentenbasierte Workflows, bei denen das Modell externe Werkzeuge nutzt und mehrstufige Aufgaben koordiniert. Wir übernehmen den Betrieb, die Überwachung und den Support, sodass sich unsere Kunden auf die Integration von KI in ihre Prozesse konzentrieren können.
Mehr Neuigkeiten
29.09.2026 | Neuigkeiten
GLM‑5.3‑Flash: Multimodales Open‑Weights‑Modell auf Schweizer Infrastruktur
Wir stellen seit neustem das Modell GLM‑5.3‑Flash bereit, ein nativ multimodales Open‑Weights‑Modell von Z.ai für Text‑ und Bildverarbeitung,…
18.09.2026 | Anlässe
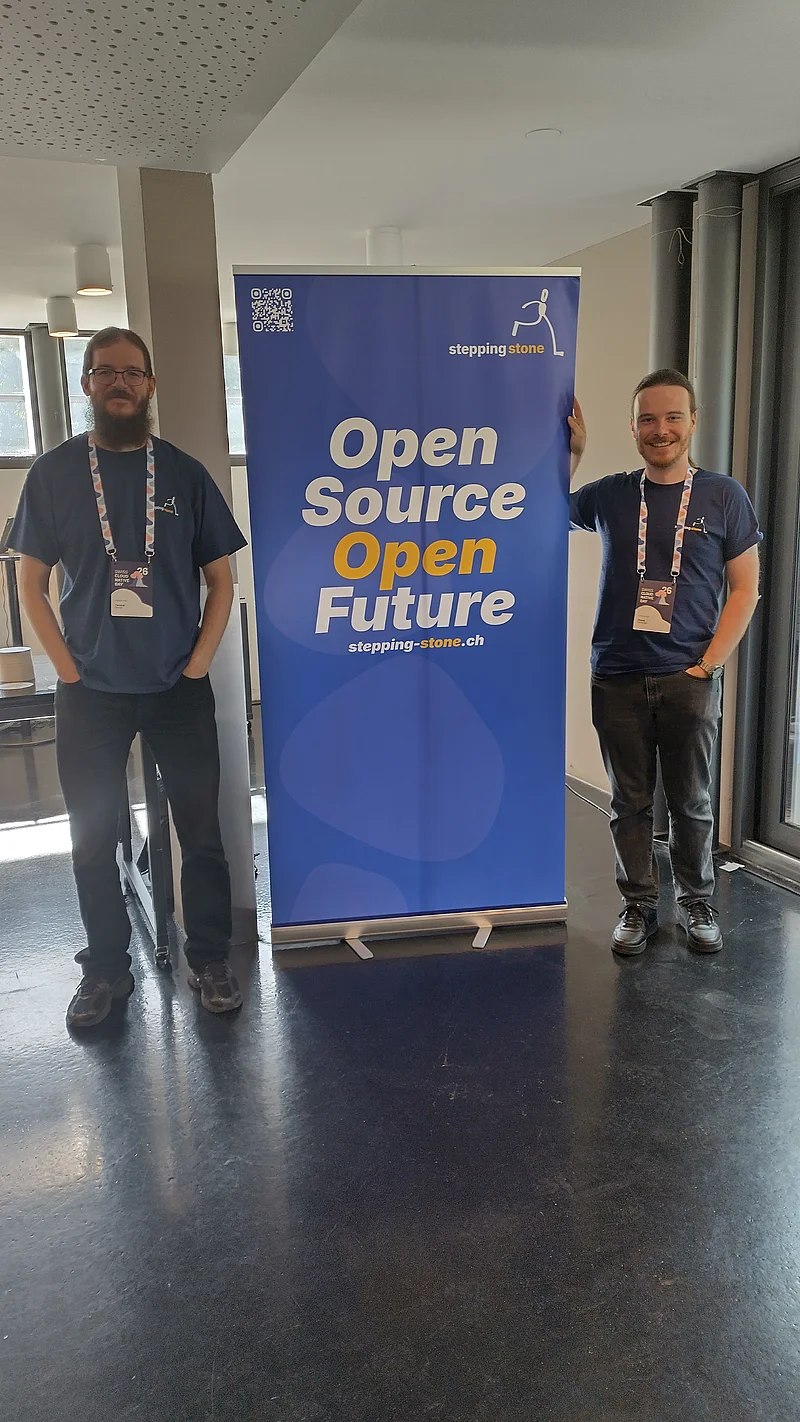
Silber Sponsor beim Swiss Cloud Native Day 2026
Ein Tag voller Cloud-Innovation, spannender Vorträge und wertvoller Begegnungen. Wir waren am Cloud Native Day 2026 als Silber-Sponsor mit dabei.
17.09.2026 | Anlässe
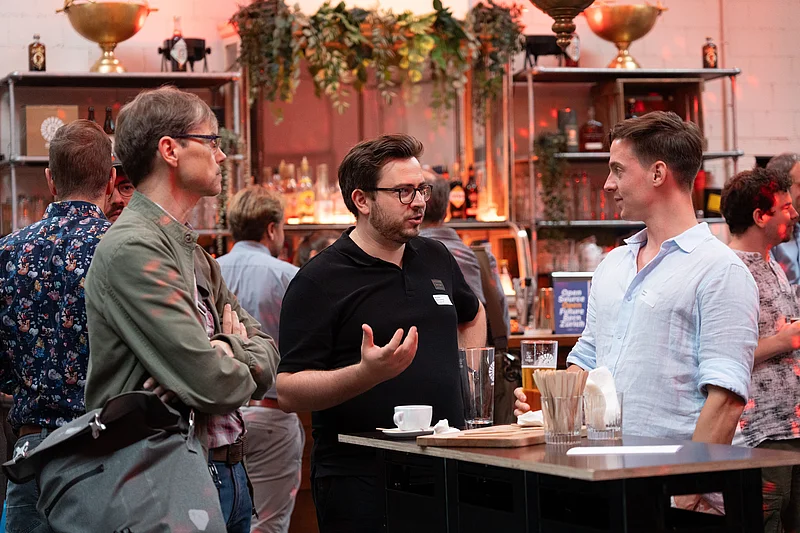
Rückblick Open Source Open Future in Zurich
Am Mittwoch, dem 16. September 2026, veranstaltete die stepping stone AG ihre jährliche Partner-, Kunden- und Networking-Veranstaltung im Amboss Rampe…
07.09.2026 | Anlässe
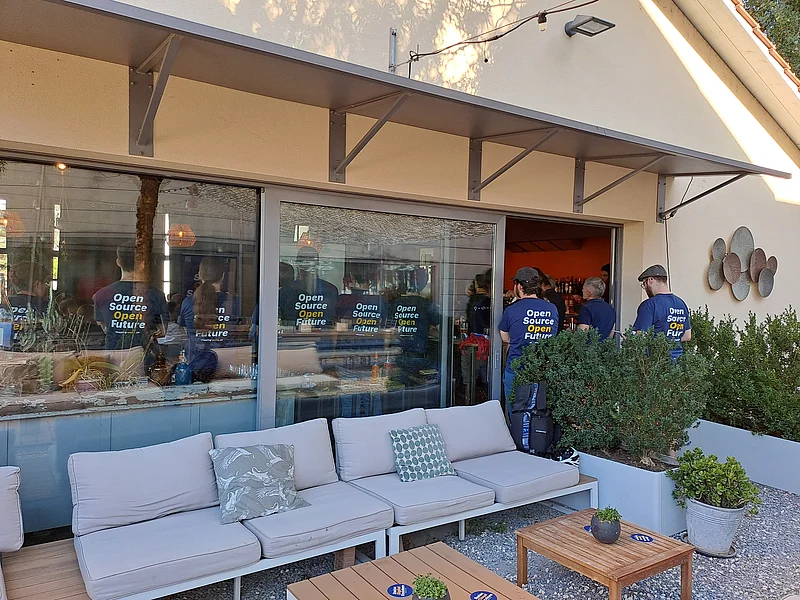
Rückblick Open Source Open Future in Bern
Am Freitag, dem 4. September 2026, veranstaltete die stepping stone AG ihre jährliche Partner-, Kunden- und Networking-Veranstaltung in der Café-Bar…

14.08.2026 | Neuigkeiten
Neue GPU Nodes in unseren Rechenzentren
Am 11. August 2026 sind vier neue GPU Nodes bei uns eingetroffen und wurden noch am selben Tag in unserem Rechenzentrum installiert.

14.08.2026 | Anlässe
Open Source Open Future 2026: Anmeldungen für Agentic AI Event sind offen
Die Anmeldungen sind seit dem 7. August 2026 geöffnet. Wir freuen uns über Ihre Anmeldung und darauf, Sie an einem der beiden Anlässe persönlich…